

東芝は2026年11月4日、大規模IoT向け時系列データベースの新版「GridDB Enterprise Edition V6.0」の提供を始めた。新版では、参照するカラムのデータだけを読み出す「列指向索引」を加え、長期間の時系列データをDWHを使わずGridDBだけで分析できるようにした。約100億件の分析時間を従来版の約70分の1に短縮した。
東芝の「GridDB」は、高頻度で大量に発生するIoTデータやビッグデータの管理に適した、スケールアウト型のデータベース管理システム(DBMS)である(関連記事:東芝デジタルソリューションズ、IoT向けデータベース新版「GridDB 5.1」、データセンター障害時の可用性を確保)。時系列データを効率よく蓄積できることを訴求している。データはRDBのテーブルに似た「コンテナ」で管理する。カラムに索引を設定でき、SQLで操作できる。
GridDBの新版(V6.0)では、索引の新しい種別として「列指向索引」を追加した(図1)。従来の索引は、ツリー索引(B-Tree索引)と、位置情報を扱う空間索引である。このうちツリー索引は、指定したカラムの値が特定の値と一致するロウ(行)や、特定の範囲に収まるロウを探す。
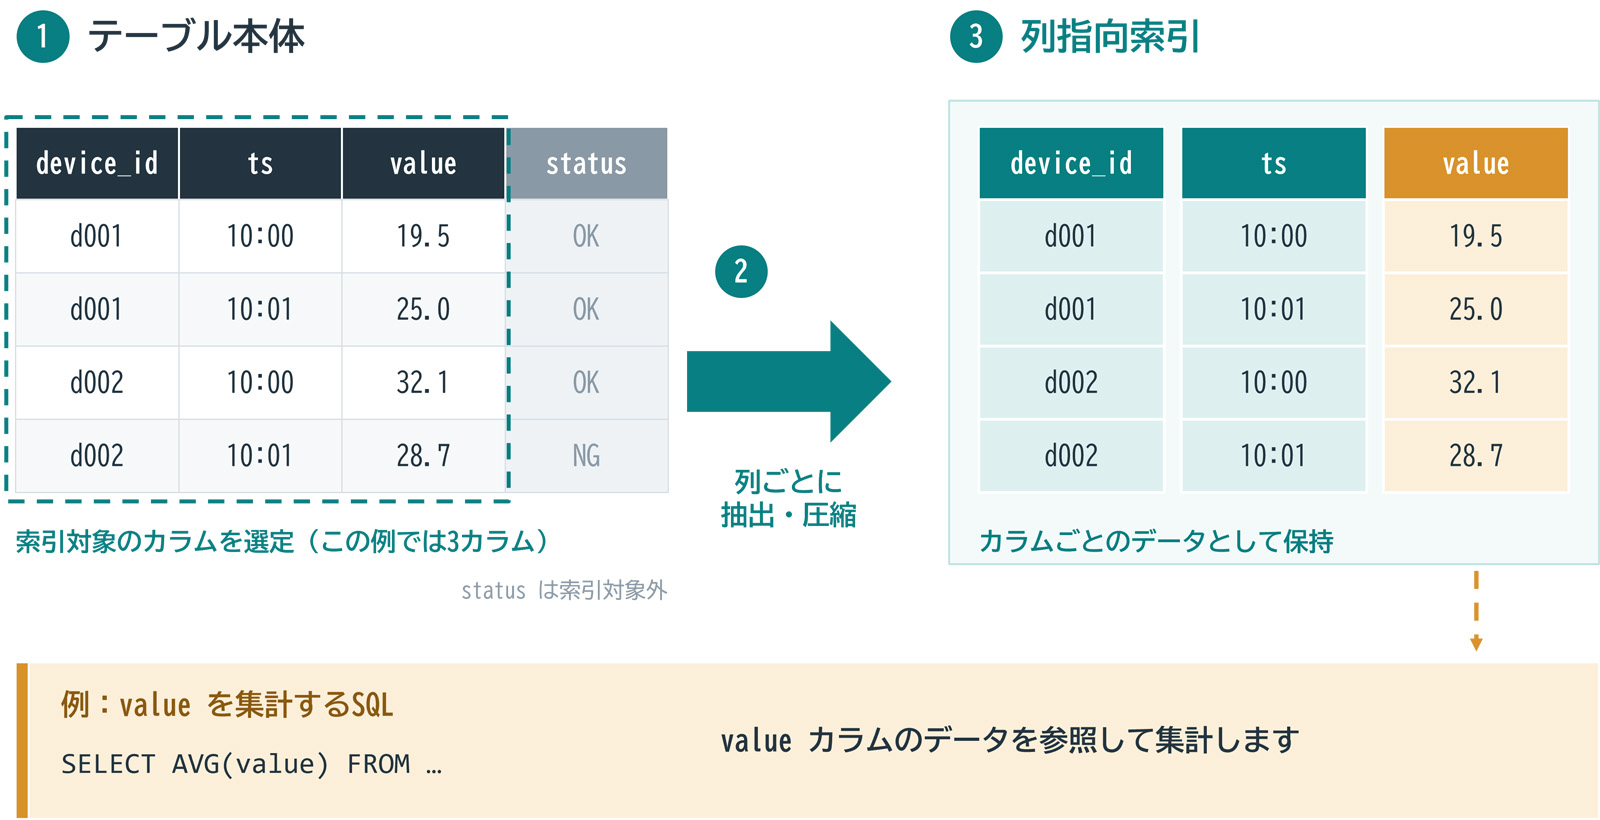 図1:新たに追加した「列指向索引」機能の概要(出典:東芝)
拡大画像表示
テーブル本体はロウ(行)単位でデータを保持するため、一部のカラムだけを参照する集計や分析のクエリーでも、参照しないカラムのデータまで読み出す。大量のデータを蓄積したテーブルでは、ストレージからの読み出し量が増え、処理時間が長くなりやすい。
新たに追加した列指向索引は、テーブル本体を従来どおり行単位で保持しつつ、指定したカラムのデータを別領域に列単位で保持する。クエリーの実行時は、参照するカラムのデータだけを読み出すので、読み出し量とメモリー使用量が減る。多数のカラムを持つ大規模テーブルにおいて一部のカラムを集計する場合、ロウを探すツリー索引よりも効果が大きい。
列指向索引は、収集したデータを蓄積するテーブルに直接作る。このテーブルの上で分析クエリーが速く動くため、分析用にデータをDWHに移す必要がなくなり、GridDB上で直接分析できるようになる(図2)。データの収集基盤と分析基盤が1つになるので、設備監視、予兆保全、品質管理、需給最適化など、リアルタイム性が要るシステムで判断を早められる。
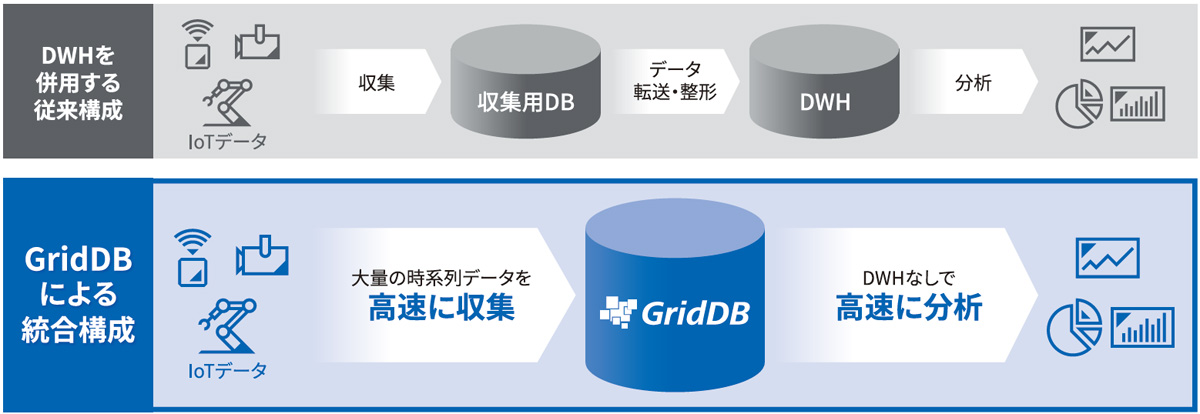 図2:DWHを使わずGridDB上で大規模IoTデータを収集・分析できるようにした(出典:東芝)
拡大画像表示
SQLの「CREATE INDEX」文に「USING COLUMNAR」を指定すると、列指向索引を作成できる。「USING」句を省くと、従来どおりツリー索引になる。実行時にGridDBが索引の種別を自動で選んで使う。テーブルにデータを登録、更新、削除すると、列指向索引は、変更があった範囲の索引データをバックグラウンドで作り直す。
東芝は、約100億件の長期間時系列データを分析し、効果を測った。従来版で2900秒かかった処理が41秒で終わり、処理時間は約70分の1になった。データセットは、日時、文字列、数値からなる20カラムの工場IoTデータである。サーバー6台のクラスタ構成で、各サーバーは6コアCPU、64GBメモリー、12TBのHDDを搭載する。クエリーは、日時の期間で絞り込んだうえで、20カラムのうち1~3カラムの値を合計するものを使った。


- 業務システム 2027年4月強制適用へ待ったなし、施行迫る「新リース会計基準」対応の勘所【IT Leaders特別編集版】
- 生成AI/AIエージェント 成否のカギは「データ基盤」に─生成AI時代のデータマネジメント【IT Leaders特別編集号】
- フィジカルAI AI/ロボット─Society 5.0に向けた社会実装が広がる【DIGITAL X/IT Leaders特別編集号】
- メールセキュリティ 導入のみならず運用時の“ポリシー上げ”が肝心[DMARC導入&運用の極意]【IT Leaders特別編集号】
- ゼロトラスト戦略 ランサムウェア、AI詐欺…最新脅威に抗するデジタル免疫力を![前提のゼロトラスト、不断のサイバーハイジーン]【IT Leaders特別編集号】


